Votre prestataire doit-il aussi héberger le logiciel qu'il développe ?
C'est le jour de la mise en ligne que la vraie question se pose : qui fait tourner tout ça, maintenant ? Voici les trois réponses possibles, ce qui finit par casser dans chacune, et les questions qui permettent de savoir si un prestataire sait réellement exploiter ce qu'il a construit. Notre propre installation sert d'exemple.
Oct 10, 2026
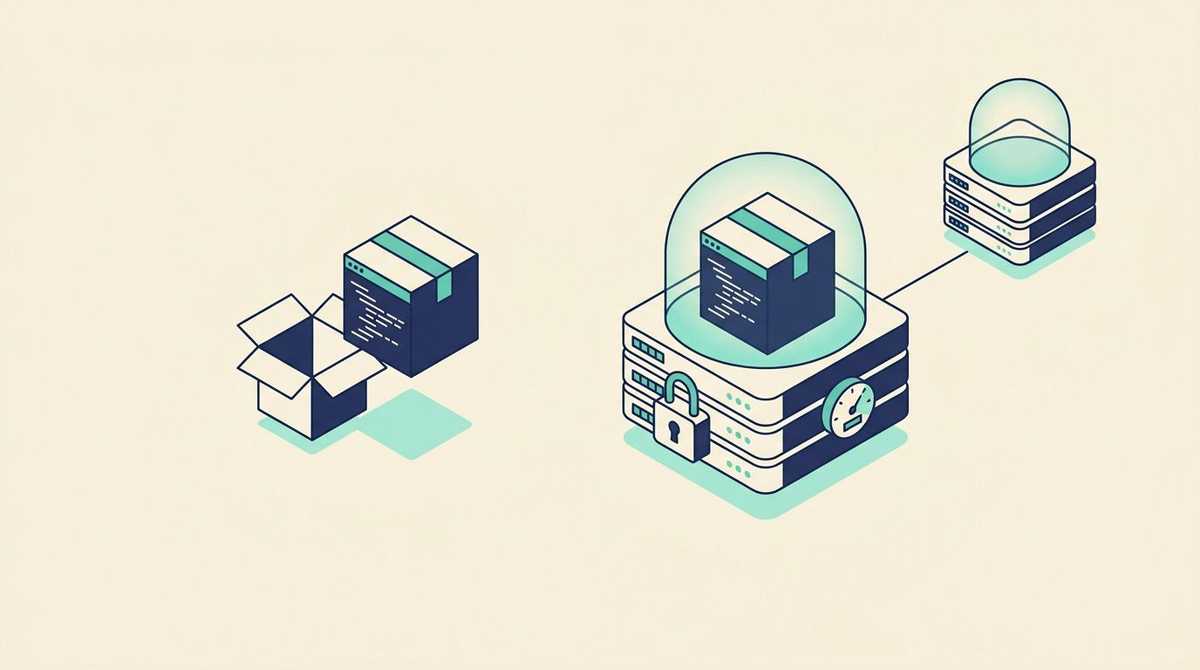
L'application fonctionne, et l'équipe qui va s'en servir l'a essayée en préproduction avec plaisir. C'est alors que quelqu'un pose la question que personne n'avait inscrite au cahier des charges : où va-t-elle tourner, et qui va s'en occuper ?
La plupart des acheteurs y voient une simple affaire d'hébergement, une ligne de budget quelque part entre le nom de domaine et le contrat de maintenance, alors que c'est de cette décision que dépend l'état du logiciel dans deux ans. L'essentiel de ce qui tourne mal dans un logiciel métier survient après la mise en ligne, et presque jamais à cause du code.
Faut-il confier l'hébergement au prestataire qui a développé l'application ? Parfois oui, parfois clairement non : voici comment trancher.
Quelles sont les options après la mise en ligne ?
Il en existe trois, et toutes les formules qu'on vous proposera se ramènent à l'une d'elles.
- Vous récupérez le code et l'exploitez vous-même. Le prestataire vous remet le dépôt, un guide de déploiement et, dans le meilleur des cas, la configuration de l'infrastructure. Votre équipe, ou votre infogérant, le déploie et le maintient en service.
- Un hébergeur ou un infogérant généraliste le fait tourner. Il garde les serveurs en vie, mais il n'a pas écrit l'application et n'y touchera pas.
- L'équipe qui l'a construit l'exploite. Hébergement, supervision, mises à jour de sécurité et évolutions restent entre les mains de ceux qui connaissent le code.
Aucune de ces options n'est la bonne par principe. Tout dépend de qui, chez vous, s'apercevrait un mardi à 7 h du matin que quelque chose ne va pas. Et de qui serait capable de le réparer.
Qu'est-ce qui tourne mal, concrètement, après la mise en ligne ?
Pas le code. Dans les projets que nous reprenons, les incidents qui font mal relèvent presque toujours de l'exploitation :
- Un identifiant fuite. Une clé d'API traîne dans un fichier de configuration qui a fini dans un dépôt, sur un drive partagé ou dans un fil d'e-mails ; comme elle fonctionne depuis deux ans, personne n'a pensé à la renouveler.
- La sauvegarde que personne n'a testée. Activées au lancement, les sauvegardes n'ont jamais été restaurées une seule fois : personne ne sait donc si elles marchent.
- Une modification part en production sans test. Un correctif rapide est déployé directement sur le système en service, un vendredi après-midi, parce qu'il n'a jamais existé de préproduction fidèle à la production.
- Personne ne surveille. Le disque de la base se remplit en trois semaines, et la première alerte arrive sous la forme d'un e-mail de client.
- La seule personne qui savait s'en va. L'installation vivait dans sa tête, ou sur un serveur configuré à la main, et la suite tient de l'archéologie.
Chacun de ces incidents coûte peu à prévenir. Il coûte cher à réparer. Toute la question est de savoir à qui revient la prévention.
Quand vaut-il mieux héberger le logiciel soi-même ?
Récupérez le code et exploitez-le vous-même si toutes ces conditions sont réunies :
- Vous disposez d'une équipe d'exploitation, ou d'un infogérant, qui fait déjà tourner des systèmes en production et assure une astreinte.
- Vos contraintes de sécurité ou réglementaires imposent que le logiciel tourne dans votre propre compte cloud ou dans votre centre de données.
- Vous prévoyez d'internaliser le développement, si bien que ceux qui l'exploitent seront bientôt aussi ceux qui le modifient.
Dans ce cas, la chose la plus importante à exiger du prestataire est une infrastructure décrite en code : serveurs, bases de données, réseaux et gestion des secrets écrits sous forme de fichiers que votre équipe peut lire et rejouer, et non un PDF de quarante pages rempli de captures d'écran. Sans cela, la « passation » revient à laisser votre équipe reconstituer l'installation à tâtons.
Quand vaut-il mieux confier l'exploitation à celui qui a développé ?
Laissez l'équipe qui l'a construit faire tourner le logiciel si :
- Personne en interne n'exploite de systèmes en production, et vous ne comptez pas recruter pour cela.
- Vous prévoyez de continuer à faire évoluer le logiciel. Ceux qui ont écrit le code sont les mieux placés pour le modifier sans risque, et séparer « qui le modifie » de « qui l'exploite » crée un angle mort où les problèmes s'engouffrent.
- Vous voulez un seul interlocuteur responsable en cas de panne, plutôt qu'un hébergeur et un développeur qui s'expliquent chacun pourquoi la faute revient à l'autre.
Le risque de cette option, c'est la dépendance : un risque bien réel, mais qui se neutralise facilement avec la dernière question de la liste ci-dessous.
Les 8 questions à poser à tout prestataire qui propose d'héberger votre logiciel
Ces questions distinguent un prestataire qui exploite réellement des logiciels d'un autre qui loue un serveur en croisant les doigts. Pour chacune, nous donnons notre propre réponse, à titre d'exemple de ce qu'une bonne réponse doit contenir.
1. L'infrastructure est-elle décrite en code ?
Demandez à la voir : une installation qui n'existe que sous la forme d'un serveur configuré à la main ne peut être ni relue, ni reproduite, ni transmise.
Chez nous : toute l'infrastructure est écrite en Terraform, avec des environnements de préproduction et de production séparés, et elle ne change qu'au travers de pull requests relues. L'historique indique qui a modifié quoi, et quand.
2. Où sont conservés les mots de passe et les clés d'API ?
La seule réponse acceptable est un gestionnaire de secrets. Pas des fichiers d'environnement posés sur un serveur, pas le dépôt de code, pas un document partagé rempli de mots de passe.
Chez nous : les identifiants sont conservés dans HashiCorp Vault, au sein du cluster et déverrouillé par Google Cloud KMS, ainsi que dans Google Secret Manager. L'application les reçoit au moment de son exécution. Les services s'authentifient auprès de Google Cloud grâce à Workload Identity : aucun fichier de clé longue durée ne risque donc de fuiter.
3. Comment accède-t-on aux outils d'administration et à la base de données ?
Si la réponse évoque un port de base de données ouvert sur Internet, ou un mot de passe d'administration partagé, inutile d'aller plus loin.
Chez nous : les nœuds du cluster n'ont aucune adresse IP publique, et les outils d'administration comme l'accès aux bases ne sont joignables que depuis notre réseau privé Tailscale. La politique de ce réseau est versionnée dans un dépôt et appliquée par la CI : elle ne peut donc pas s'écarter de ce qui a été relu. Lorsque l'audit de sécurité d'un client l'exige, nous restreignons l'accès à des personnes et à des services nommément désignés ; c'est une modification du fichier de politique, pas un chantier.
4. Comment une modification arrive-t-elle en production ?
Vous voulez entendre « d'abord en préproduction, vérifiée automatiquement, puis promue », et non « on déploie quand c'est prêt ».
Chez nous : chaque pull request passe une analyse statique avec règles de sécurité, une recherche de vulnérabilités dans les dépendances et une revue de sécurité automatisée, qui bloque la fusion dès qu'elle relève un problème. Une version mise en production est exactement l'image qui a déjà tourné en préproduction, et des tests de bout en bout s'exécutent chaque jour sur la préproduction. Revenir en arrière consiste à redéployer l'image précédente.
5. Comment les sauvegardes sont-elles faites, et quand en avez-vous restauré une pour la dernière fois ?
C'est la seconde moitié de la question qui compte, car une sauvegarde que personne n'a jamais restaurée relève de l'espoir, pas de la sauvegarde.
Chez nous : les bases de données sont des instances PostgreSQL gérées par Google Cloud SQL, sauvegardées automatiquement chaque jour, avec sept jours de conservation. Lorsqu'un projet exige un point de reprise plus fin, nous activons sur cette base la restauration à un instant précis, ce qui permet de revenir à une minute donnée plutôt qu'à la veille au soir.
6. Qui surveille, et comment est-il prévenu ?
« On vérifie régulièrement » n'a rien d'une supervision : demandez ce qui déclenche une alerte, et qui la reçoit.
Chez nous : des règles d'alerte Google Cloud Monitoring, définies dans le même code d'infrastructure, surveillent la charge processeur, la mémoire et le disque des bases de production, ainsi qu'une croissance anormale du disque, et nous préviennent. Les erreurs applicatives sont suivies avec leur contexte.
7. Où se trouvent physiquement les données ?
La question compte pour le RGPD en Europe, pour les clauses de localisation des données dans les contrats américains, et pour les questions que vos propres clients vous poseront.
Chez nous : par défaut, notre plateforme tourne sur Google Cloud dans la région europe-west1, en Belgique. Pour un projet dont les données doivent rester aux États-Unis, ou dans un compte Google Cloud qui vous appartient, nous mettons en place cette région ou ce compte pour le projet, et c'est intégré au périmètre comme au prix dès le départ.
8. Si nous partons, qu'emportons-nous ?
C'est la question qui neutralise la dépendance, et la réponse attendue tient en une phrase : le code source, le code d'infrastructure et la documentation, inscrits au contrat comme vous appartenant.
Chez nous : les trois vous appartiennent, contractuellement. Comme l'infrastructure est décrite en code, la plateforme entière peut être redéployée dans votre propre compte cloud, ou exploitée par votre équipe ou par un autre prestataire, sans rien avoir à reconstituer.
Et si le prestataire n'est pas certifié SOC 2 ?
La plupart des petites sociétés de développement ne le sont pas, nous compris, et la certification offre certes un raccourci commode à un service achats, mais elle ne garantit pas qu'un logiciel soit bien exploité, et une équipe non certifiée peut répondre à chacune des questions ci-dessus preuves à l'appui.
Ce que vous êtes en droit d'attendre, en revanche, c'est une réponse franche à votre questionnaire de sécurité, point par point, tirée des systèmes réels plutôt que d'un modèle de politique, y compris sur les points où le prestataire n'atteint pas votre niveau d'exigence. Si vos achats imposent un rapport SOC 2 à chaque fournisseur, dites-le dès le premier échange : un bon prestataire vous dira tout de suite s'il peut convenir. Nous avons détaillé notre façon de répondre aux questionnaires de sécurité.
En résumé
Si vous avez une équipe qui exploite des systèmes en production, récupérez le code et exigez une infrastructure décrite en code, pour que la passation ne soit pas un vain mot. Dans le cas contraire, confiez l'exploitation à celui qui a développé, et servez-vous des huit questions pour vérifier qu'il en est capable :
- L'infrastructure est-elle décrite en code ?
- Où sont conservés les mots de passe et les clés d'API ?
- Comment accède-t-on aux outils d'administration et à la base de données ?
- Comment une modification arrive-t-elle en production ?
- Comment les sauvegardes sont-elles faites, et quand en avez-vous restauré une pour la dernière fois ?
- Qui surveille, et comment est-il prévenu ?
- Où se trouvent physiquement les données ?
- Si nous partons, qu'emportons-nous ?
Nos propres réponses, au complet et avec ce que nous ne revendiquons pas, figurent sur notre page sécurité. Et si vous êtes une entreprise américaine qui envisage de travailler avec une équipe basée en France, cette page détaille les horaires, les contrats et les prix en dollars.